TradingAgents: як мультиагентна LLM-система відтворює роботу трейдингової фірми
Головне за 30 секунд
- TradingAgents — відкритий фреймворк (Apache-2.0), у якому LLM-агенти грають ролі аналітиків, дослідників, трейдера, ризик-менеджерів і фонд-менеджера, як у справжній трейдинговій фірмі.
- Агенти обмінюються структурованими звітами, а природну мову використовують лише в дебатах. Так автори борються з «ефектом зіпсованого телефону» в довгих діалогах.
- У бектесті з 1 січня по 29 березня 2024 року фреймворк показав 23–27% кумулятивної дохідності на AAPL, GOOGL і AMZN при просіданні до 2,11%.
- Автори самі визнають обмеження: лише 3 місяці тесту через вартість (11 викликів LLM і 20+ викликів інструментів на одне рішення) та аномально високий коефіцієнт Шарпа.
- Проєкт призначений для досліджень і не є інвестиційною порадою; до реальної торгівлі від нього ще далеко.
Зміст
Мультиагентні системи на базі великих мовних моделей уже навчилися писати код, проводити наукові огляди й тестувати застосунки. Фінанси — наступний логічний полігон: тут багато різнорідних даних, рішення треба пояснювати, а помилка коштує грошей. Стаття TradingAgents: Multi-Agents LLM Financial Trading Framework (arXiv 2412.20138) від Yijia Xiao, Edward Sun, Di Luo і Wei Wang пропонує не ще одного «бота-трейдера», а цілу віртуальну фірму, де кожен LLM-агент має свою посаду.
Статтю опубліковано наприкінці 2024 року, на Hugging Face Papers вона зібрала понад 160 голосів, а репозиторій на GitHub на листопад 2026 року має понад 120 тисяч зірок. Нижче — технічний розбір: архітектура, протокол комунікації, експерименти та, що важливо, межі отриманих результатів.
Для розбору ми завантажили PDF статті, сторінку на Hugging Face і README репозиторію в NotebookLM, а ключові цифри звірили з оригінальною таблицею результатів.
Яку проблему розв’язує TradingAgents
Автори виходять із трьох слабких місць наявних підходів:
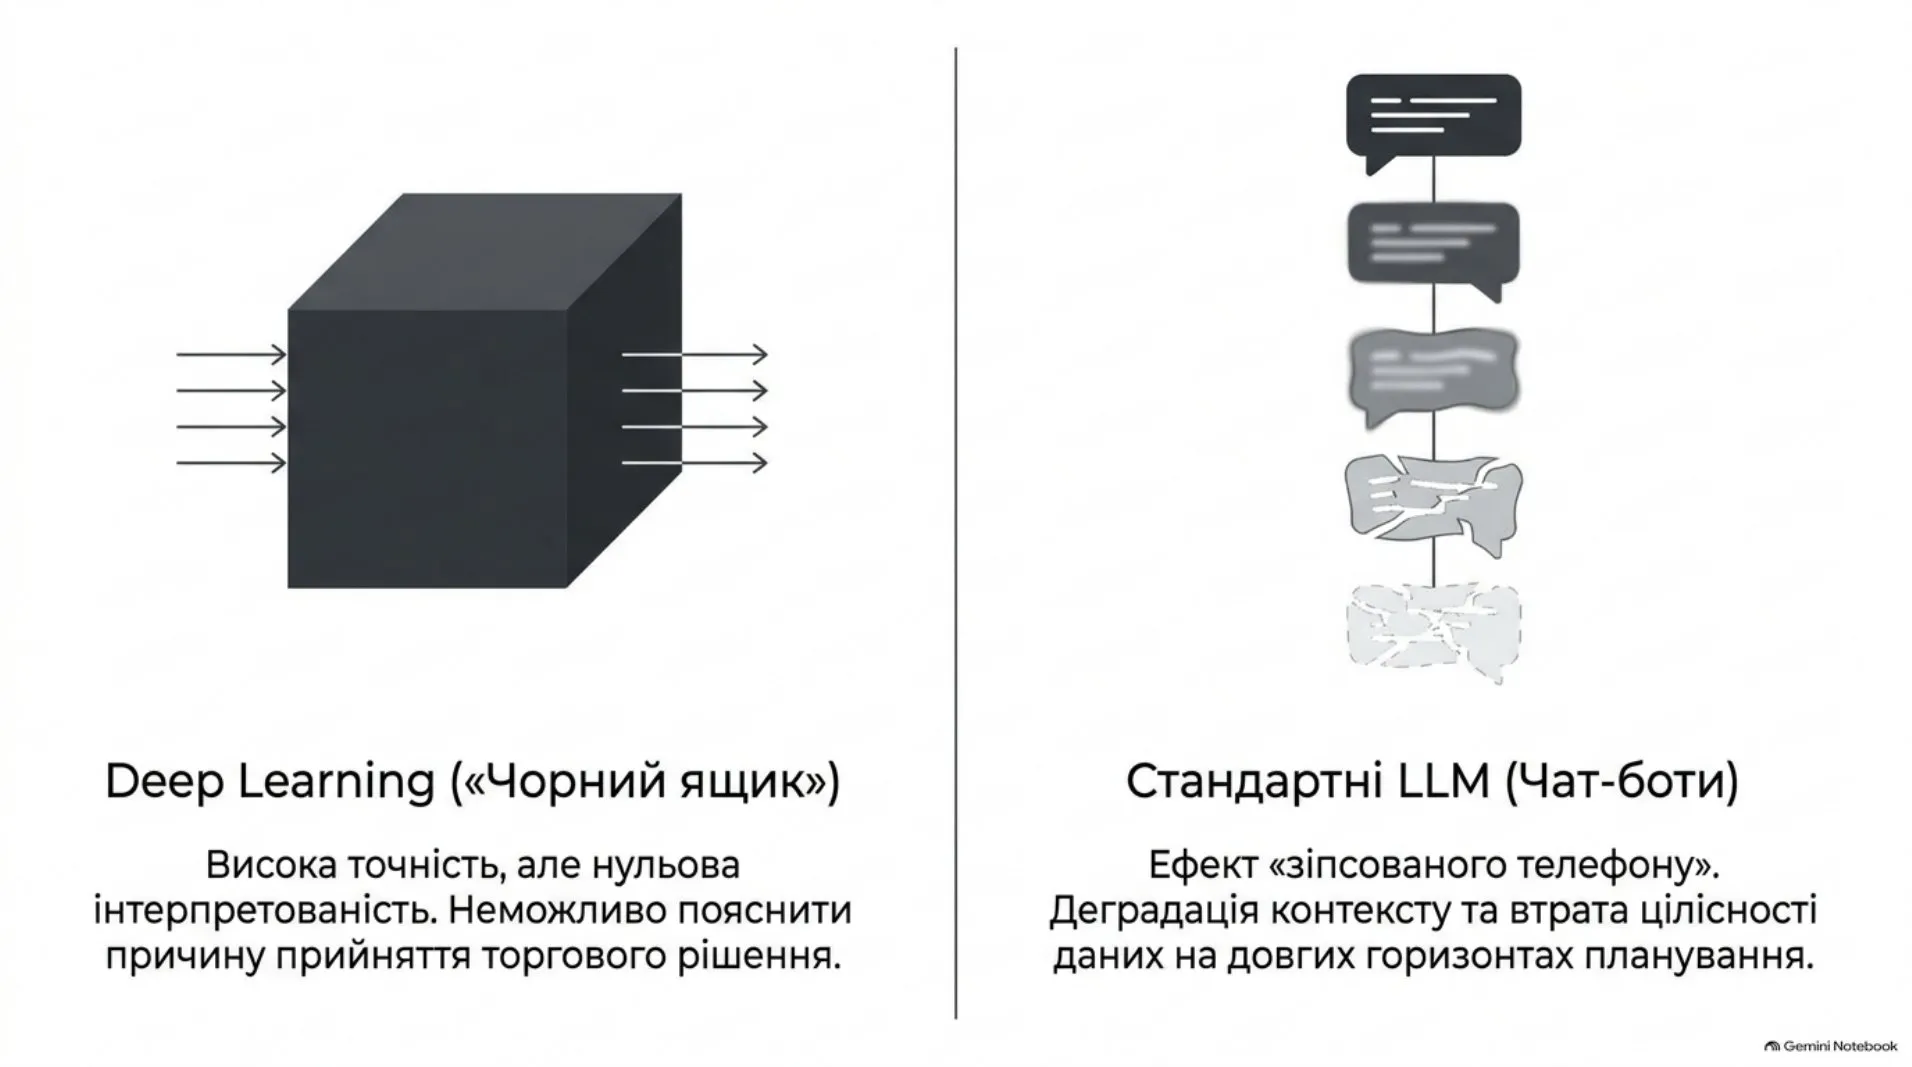
- Класичні кількісні та deep learning-моделі погано поєднують різнорідні сигнали (звітність, новини, соцмережі, технічні індикатори) і працюють як «чорна скринька». Пояснити, чому модель купила чи продала, майже неможливо.
- Одноагентні LLM-системи зазвичай закривають одну вузьку задачу: оцінку сентименту новин, аналіз звіту чи прогноз за одним показником. Реальне торгове рішення складається з багатьох таких кроків.
- Попередні мультиагентні фреймворки здебільшого паралельно збирали дані, але не відтворювали командну роботу й ієрархію, перевірені в інвестиційних компаніях.
Архітектура: фірма з п’яти команд
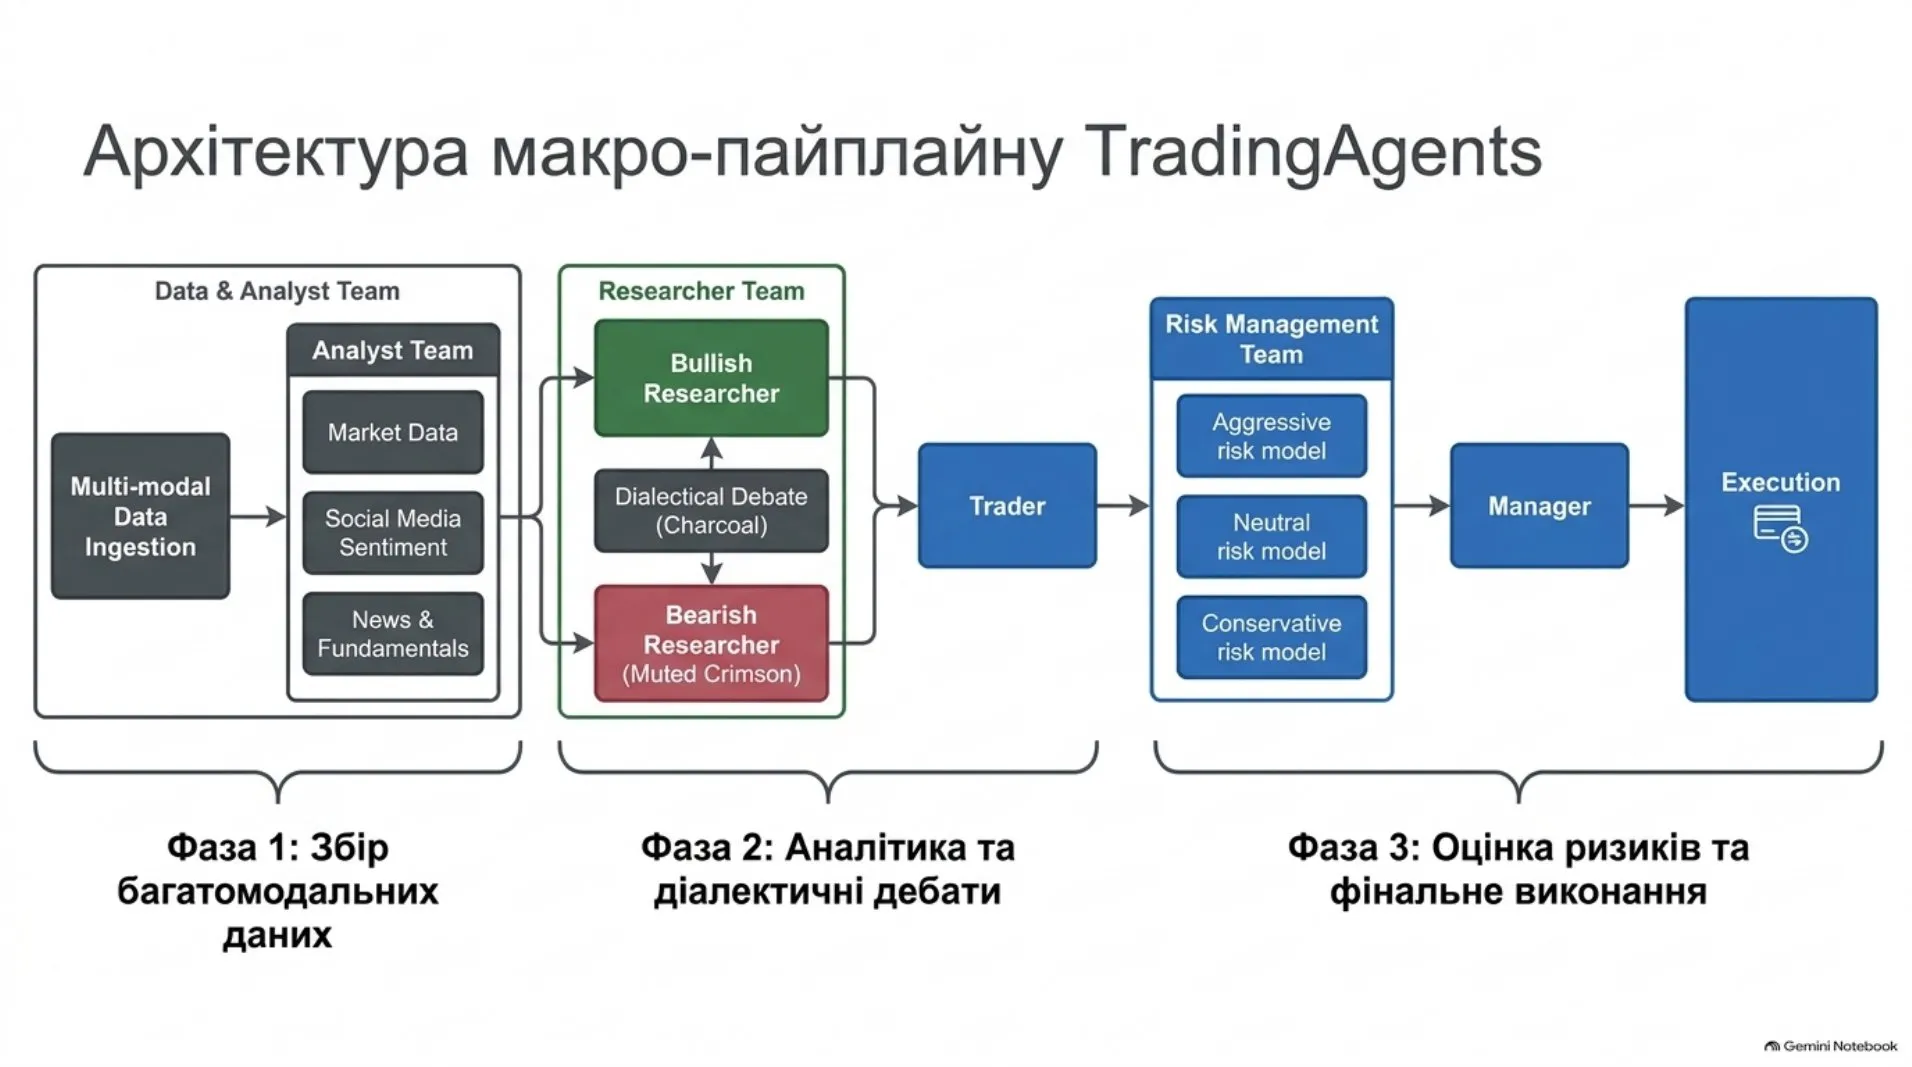
TradingAgents розкладає процес прийняття рішення на ролі, знайомі кожному, хто бачив організаційну схему хедж-фонду.
1. Команда аналітиків. Чотири агенти працюють паралельно:
- фундаментальний аналітик читає фінансову звітність, дані про угоди інсайдерів та інсайдерський сентимент;
- аналітик сентименту обробляє пости із соцмереж і оцінює короткострокові настрої інвесторів;
- аналітик новин стежить за новинами, макроекономічними показниками та ключовими подіями;
- технічний аналітик рахує індикатори на кшталт RSI, MACD і смуг Боллінджера на історичних цінах.
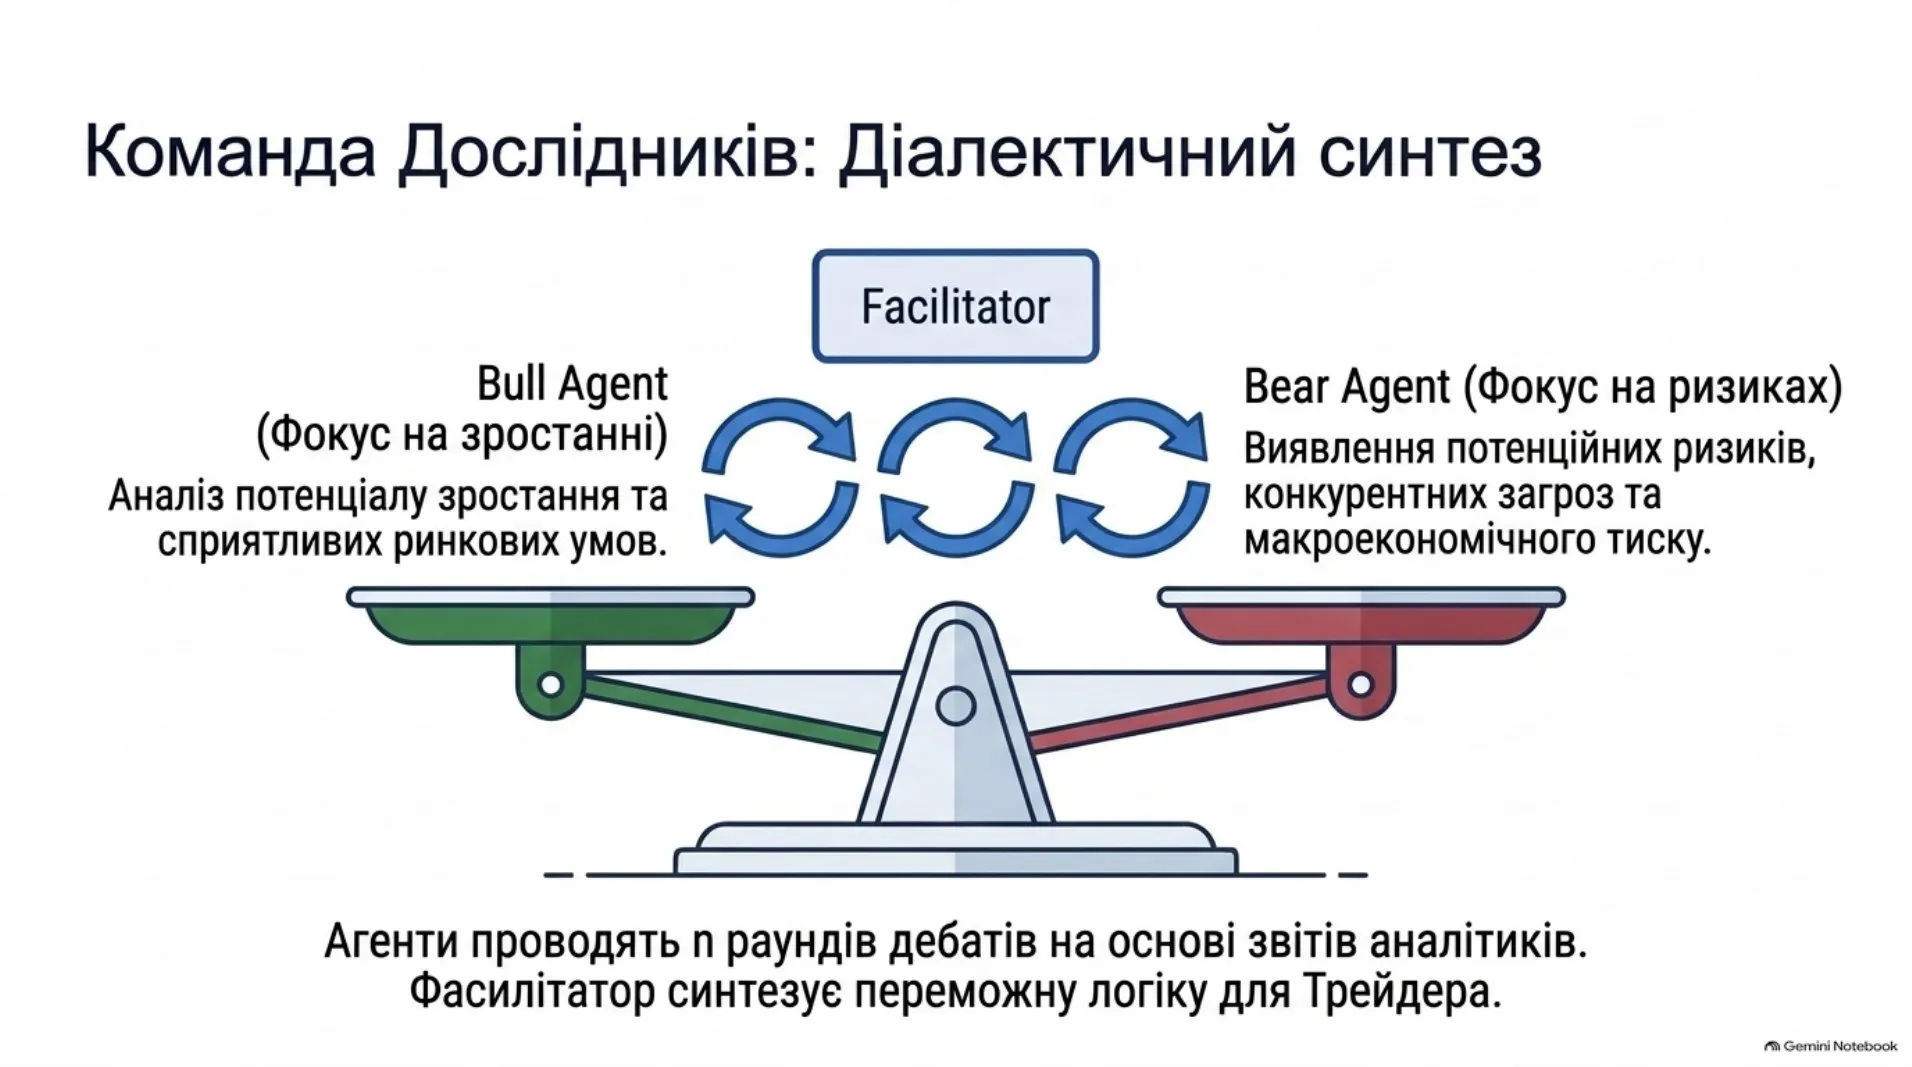
2. Дослідницька команда. Два агенти з протилежними позиціями: Bull шукає аргументи на користь угоди, Bear — ризики й слабкі місця. Вони проводять кілька раундів дебатів, а фасилітатор підсумовує дискусію й фіксує збалансований висновок.
3. Трейдер. Зводить звіти аналітиків і результати дебатів, визначає сигнал (купити, продати чи утримувати), обсяг і час угоди та готує пропозицію транзакції.
4. Команда ризик-менеджменту. Три агенти оцінюють пропозицію з різних позицій: агресивної, нейтральної та консервативної. Після обговорення вони коригують параметри угоди під ліміти ризику.
5. Фонд-менеджер. Переглядає висновки ризик-команди й ухвалює остаточне рішення: затвердити, скоригувати чи відхилити ордер.
Протокол комунікації: звіти замість чату
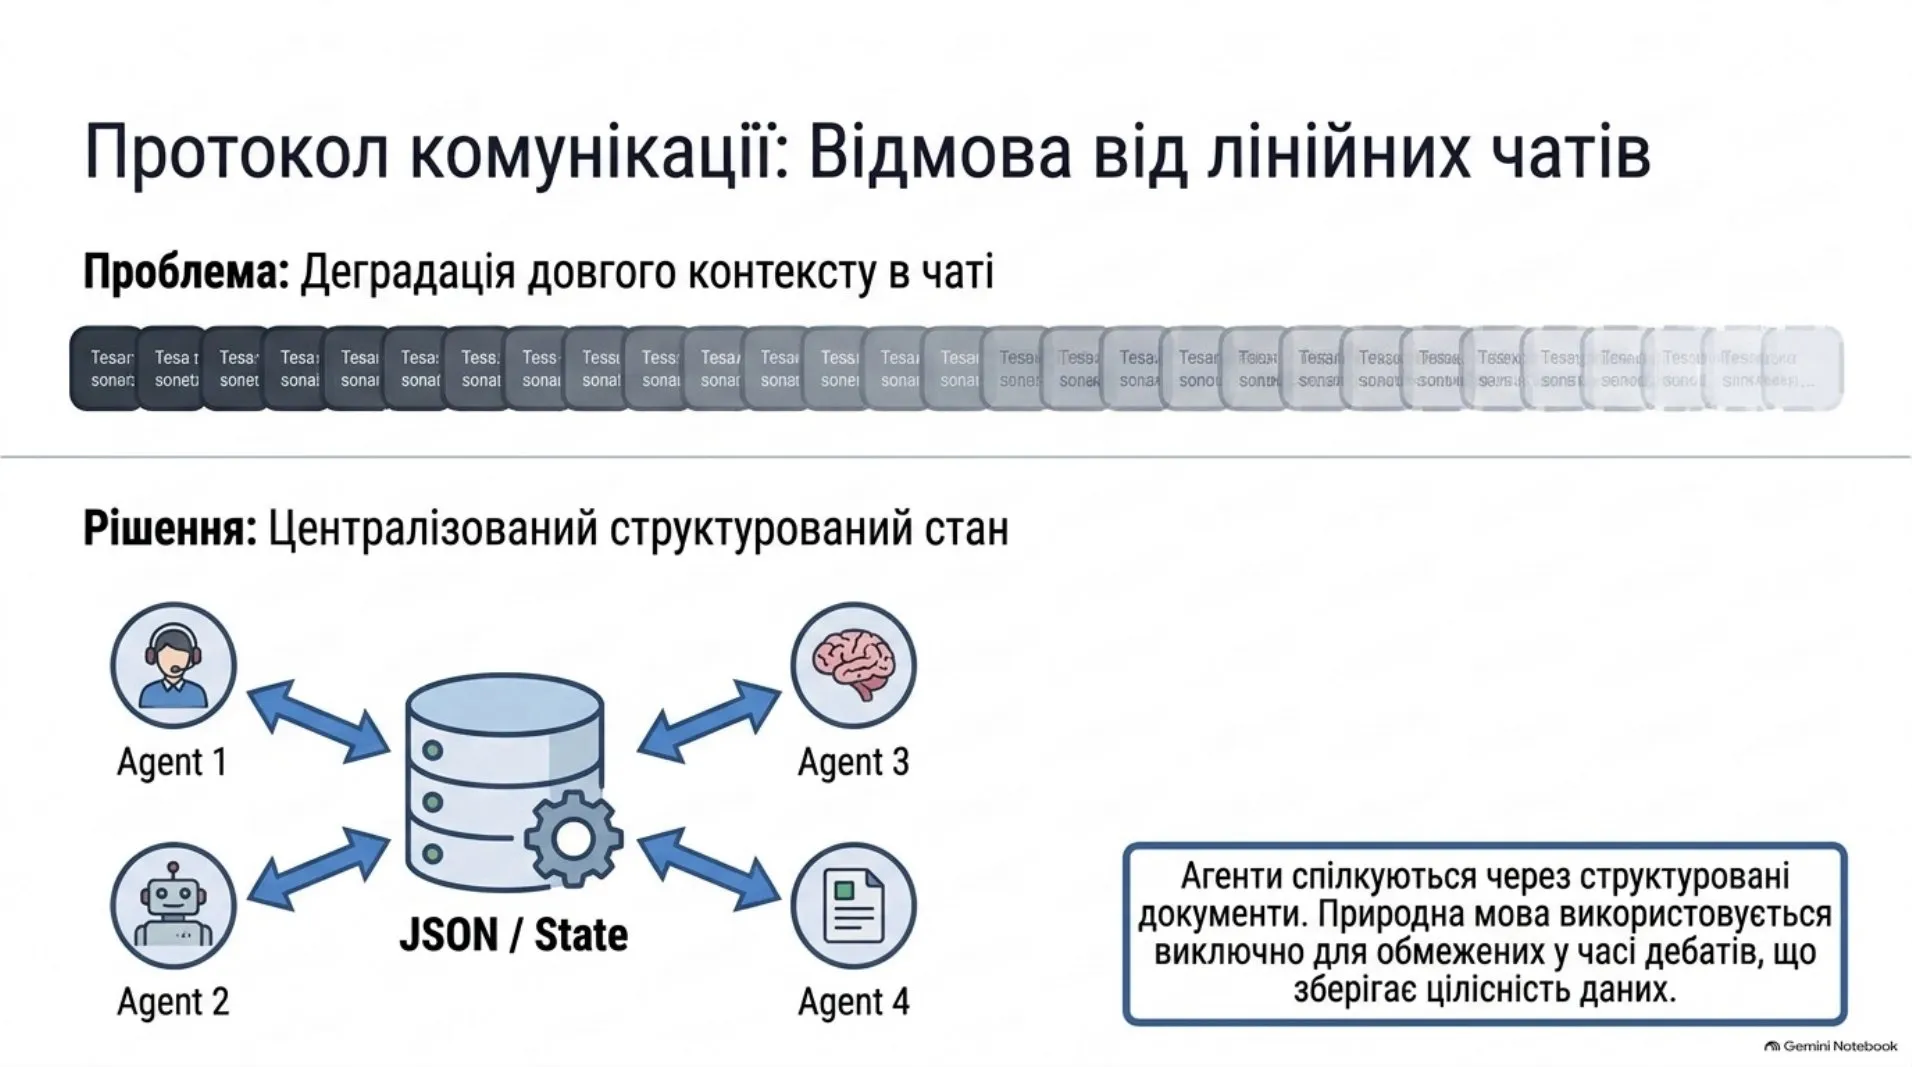
Найцікавіша інженерна ідея статті — не самі ролі, а спосіб, у який агенти спілкуються. Більшість мультиагентних систем передає контекст як довгу історію повідомлень природною мовою. На довгих ланцюжках це дає те, що автори називають «ефектом зіпсованого телефону»: контекст роздувається, первинні деталі губляться або спотворюються.
TradingAgents використовує гібридний протокол:
- між етапами передаються структуровані звіти й записи глобального стану. Кожен агент бере з цього стану лише потрібне і повертає документ фіксованого формату;
- природна мова залишається тільки там, де вона справді потрібна: у дебатах Bull/Bear і в обговоренні ризиків. Підсумок дебатів фасилітатор знову записує у стан як структурований запис.
Для розробника це знайомий патерн: shared state замість нескінченного логу повідомлень. Саме він дозволяє масштабувати кількість агентів без лавиноподібного росту контексту.
Два рівні моделей: quick-thinking і deep-thinking
Автори свідомо розділяють моделі за типом задачі. Швидкі моделі (у статті — gpt-4o-mini і gpt-4o) відповідають за підсумовування, отримання даних з API та перетворення таблиць у текст. Моделі з глибокими міркуваннями (o1-preview) працюють там, де потрібні аналіз, написання обґрунтованих звітів і ухвалення рішень: в аналітиків, дослідників і трейдера.
Практичний наслідок: фреймворк не потребує власного GPU і працює лише на API-кредитах, а базову модель можна замінити для будь-якого агента. Сучасна версія репозиторію пішла далі: окремий провайдер для кожного рівня моделей, підтримка OpenAI, Anthropic, Google, xAI, DeepSeek, Qwen, Mistral, AWS Bedrock, Azure, а також локальних моделей через Ollama чи будь-який OpenAI-сумісний сервер (vLLM, LM Studio, llama.cpp).
Кожне рішення супроводжується міркуваннями у форматі ReAct, журналом викликів інструментів і записом дебатів. Тому TradingAgents значно легше аудитувати й налагоджувати, ніж нейромережеву торгову модель.
Експерименти: що показав бектест
Фреймворк перевірили на історичних даних з 1 січня по 29 березня 2024 року. Агенти бачили лише інформацію, доступну на кожен торговий день, щоб виключити look-ahead bias. Датасет включав ціни OHLCV, новини, пости із соцмереж, звітність, угоди інсайдерів і технічні індикатори.
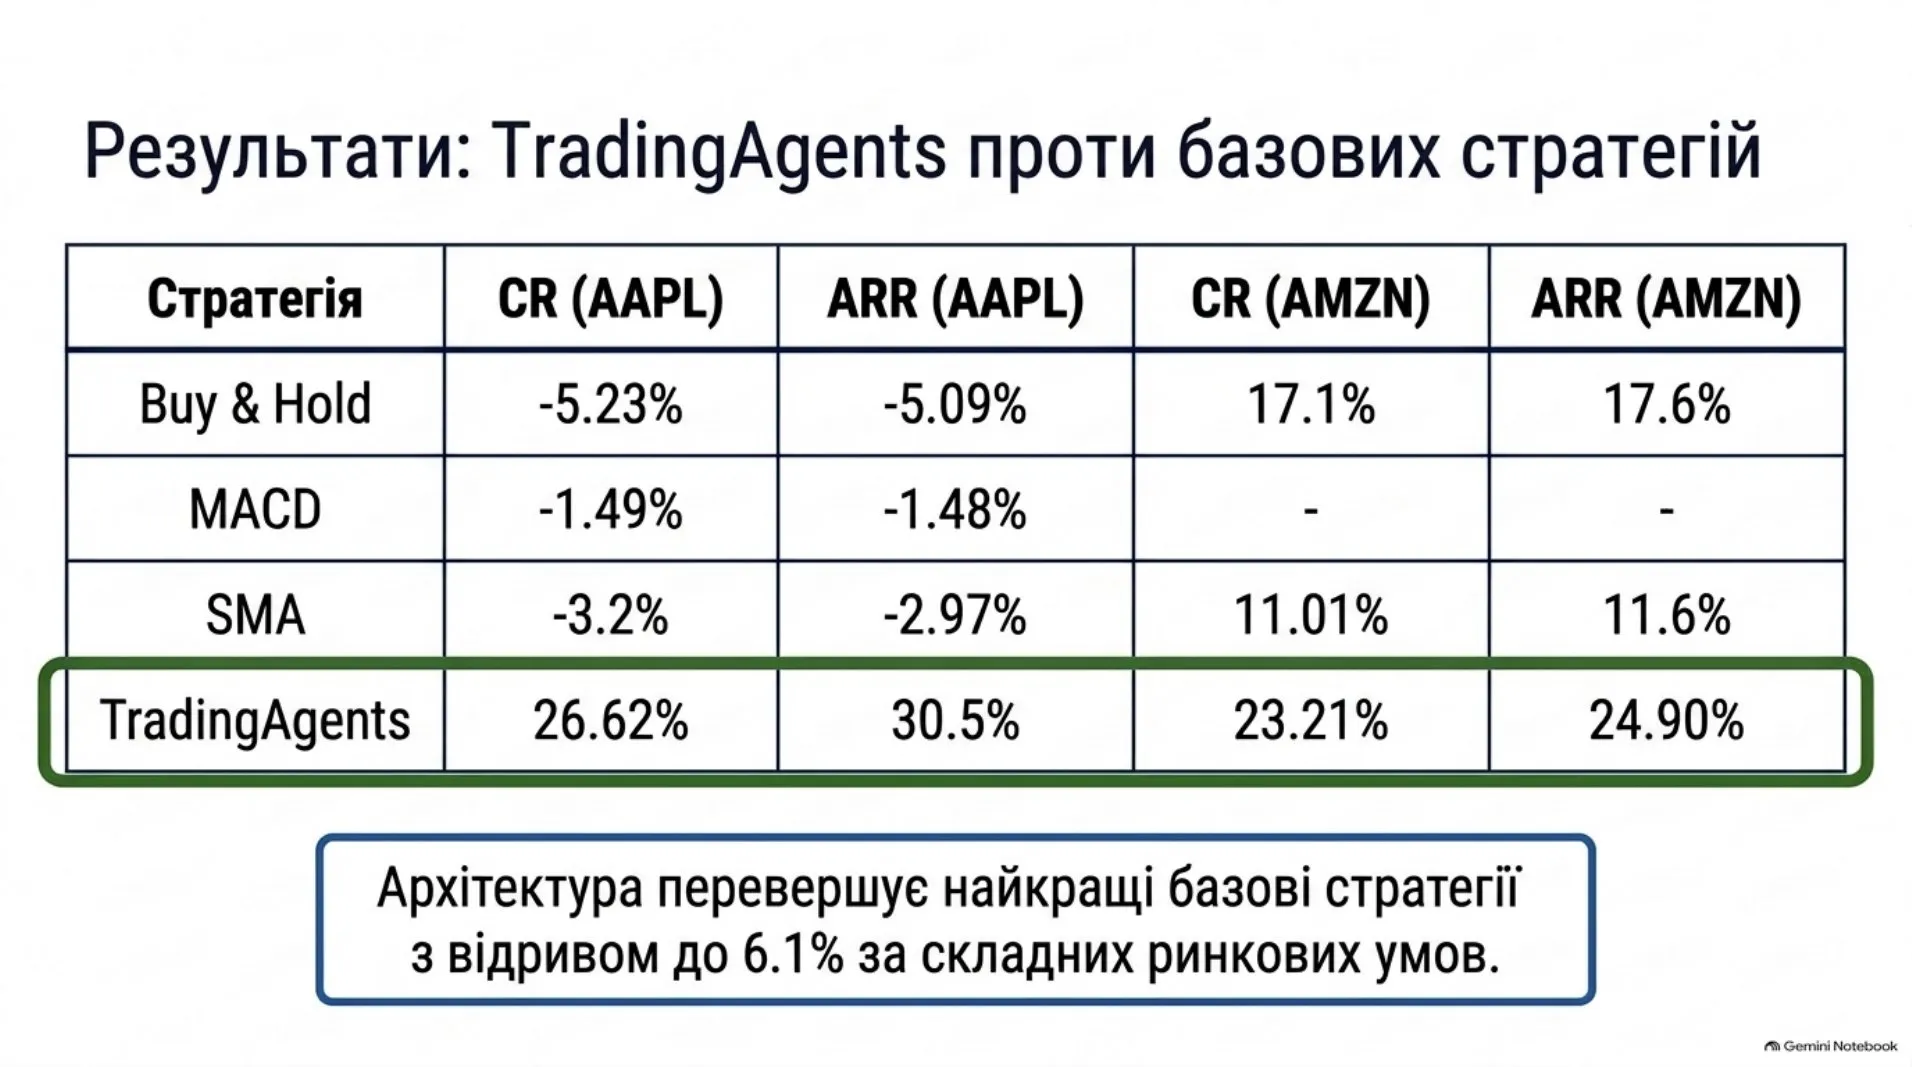
Базові стратегії для порівняння: Buy & Hold, MACD, KDJ + RSI, ZMR (повернення до середнього) і SMA. Метрики: кумулятивна дохідність (CR), річна дохідність (ARR), коефіцієнт Шарпа (SR) і максимальне просідання (MDD).
| Акція | TradingAgents: CR | ARR | Шарп | MDD | Найкращий baseline за CR |
|---|---|---|---|---|---|
| AAPL | 26,62% | 30,50% | 8,21 | 0,91% | KDJ + RSI: 2,05% |
| GOOGL | 24,36% | 27,58% | 6,39 | 1,69% | Buy & Hold: 7,78% |
| AMZN | 23,21% | 24,90% | 5,60 | 2,11% | Buy & Hold: 17,10% |
Найпоказовіший випадок — Apple: у тестовий період Buy & Hold дав −5,23%, MACD і SMA теж пішли в мінус, а TradingAgents заробив 26,62% при просіданні менше 1%. На AMZN відрив скромніший: +6,1 процентного пункту над Buy & Hold.
Межі результатів: що варто врахувати
Цифри виглядають вражаюче, і саме тому їх варто читати уважно. Частину застережень автори роблять самі:
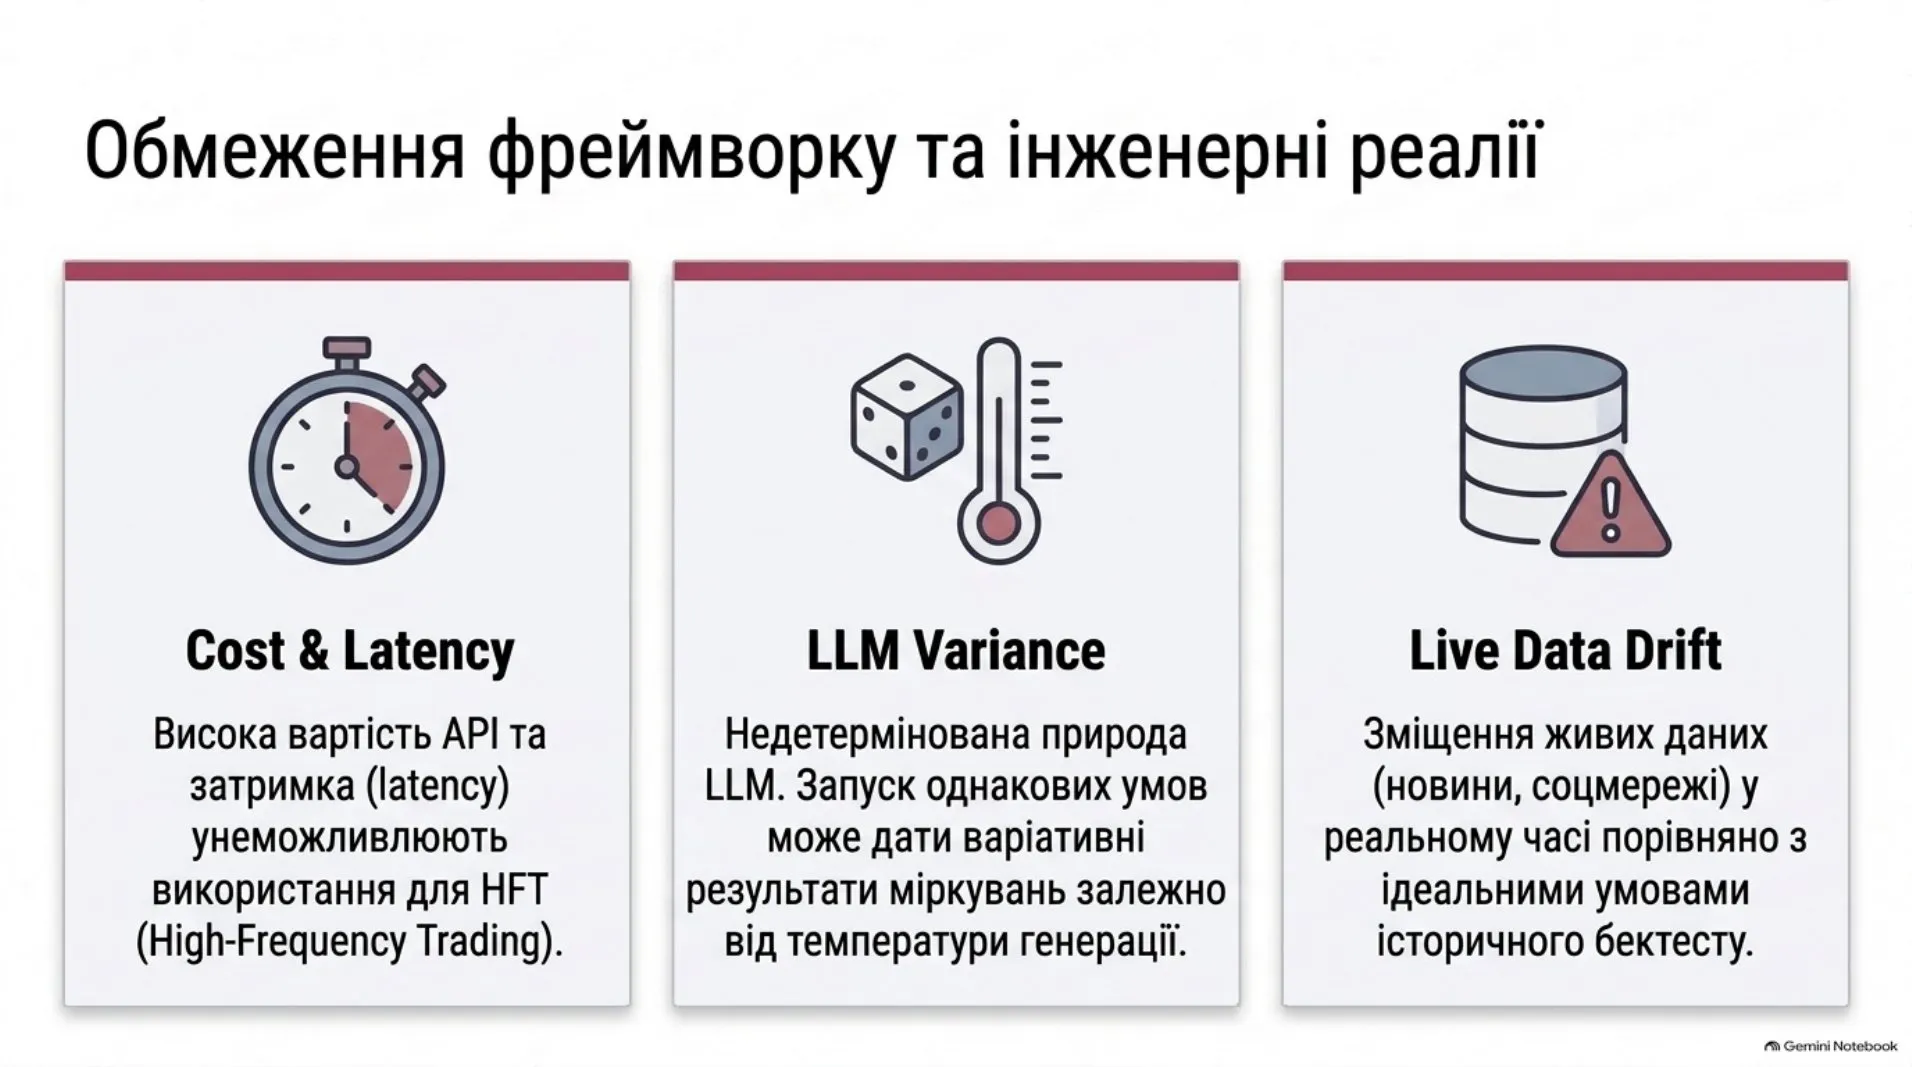
- Короткий горизонт. Тест тривав лише три місяці. Причина — вартість: одне торгове рішення потребує 11 викликів LLM і понад 20 викликів інструментів.
- Аномальний коефіцієнт Шарпа. Автори прямо пишуть, що значення понад 8 виходить за очікуваний емпіричний діапазон (вище 2 — дуже добре, вище 3 — відмінно). Вони перевірили розрахунки й пояснюють це тим, що в тестовому вікні стратегія майже не мала відкатів.
- Недетермінованість. Результат залежить від моделі, температури, якості даних і випадковості генерації. Два прогони на ту саму дату можуть дати різні рішення.
Додамо й власну експертну оцінку (це наш висновок, а не теза статті). Вибірка з трьох технологічних акцій на зростаючому ринку початку 2024 року мала для статистичних висновків. Крім того, тестовий період міг потрапити в навчальні дані використаних моделей, і тоді «знання майбутнього» могло просочитися в рішення. Нарешті, стаття не згадує комісій і прослизання, а в реальній торгівлі вони неминуче з’їдять частину дохідності.
Автори та репозиторій наголошують: TradingAgents створено для досліджень, і це не фінансова, інвестиційна чи торгова порада.
Що це означає для розробників
Навіть якщо ви не плануєте будувати торгового бота, у TradingAgents є кілька переносних ідей:
- Рольова декомпозиція працює краще за одного «універсального» агента, коли задача природно ділиться на експертизи.
- Структурований стан замість чату — дешевий спосіб тримати контекст під контролем у довгих мультиагентних ланцюжках.
- Дебати з протилежними позиціями (Bull/Bear, три профілі ризику) — практичний патерн проти підтверджувального упередження моделі.
- Розділення моделей за рівнем складності знижує вартість без втрати якості там, де вона критична.
- Пояснюваність як вимога: логи міркувань і інструментів роблять систему придатною до аудиту.
Спробувати рольову декомпозицію на власних задачах можна й без окремого фреймворку: у Claude Code для цього є субагенти з власними ролями, інструментами й моделями. Як їх налаштувати, ми розібрали в гайді по субагентах Claude Code.
Код доступний під ліцензією Apache-2.0, потребує Python 3.11+, запускається через CLI або Docker Compose. Команда також анонсувала наступний проєкт — Trading-R1, який зараз у ранньому доступі.
Висновок
TradingAgents — сильний приклад того, як ідеї мультиагентних систем переносяться у високоризикову предметну область. Головна цінність статті не в рекордних відсотках дохідності за квартал, а в інженерних рішеннях: ролі за зразком реальної фірми, гібридний протокол комунікації, дебати як механізм контролю якості та прозорі логи рішень. Результати бектесту варто сприймати як доказ працездатності концепції, а не як готову торгову стратегію. Перевірка на довшому горизонті, з комісіями та на моделях без доступу до даних тестового періоду — наступний крок, який визначить, чи стане цей підхід інструментом для ринку, а не лише для досліджень.